AIXX 百科 › 機種項目 › NVIDIA RTX PRO 6000 Blackwell Server Edition
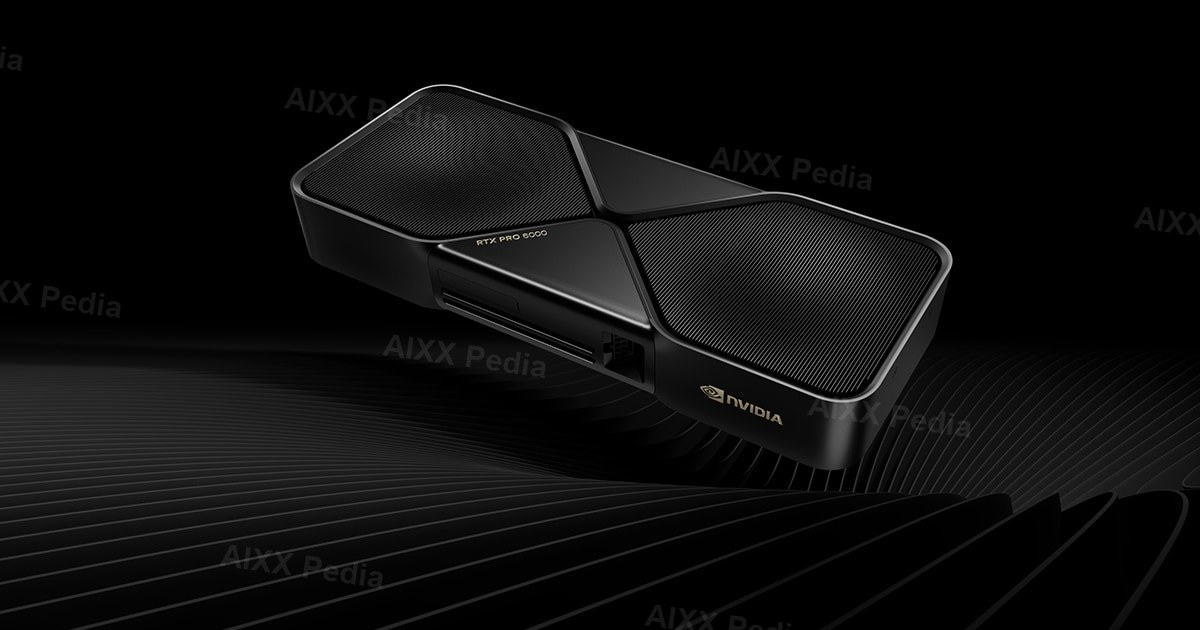
NVIDIA RTX PRO 6000 Blackwell Server Edition
概要OVERVIEW
NVIDIA RTX PRO 6000 Blackwell Server Edition(サーバー版)は RTX PRO 6000 Blackwell ファミリーのラック形態:ワークステーション版と同一チップ——96GB GDDR7 with ECC(512-bit)、24,064 個の CUDA コア、Blackwell アーキテクチャ。違いはパッシブ冷却(サーバー風路)+ 消費電力設定可(最大 600W)+ 高密度ポジショニング:複数カードのラック化 AI 推論と VDI(NVIDIA 公式およびチャネル情報[1]、2026-10 検証)。
公式情報の要点:PCIe Gen5 x16、MIG 最大 4 分割(1 スライス 24GB)——1 台のサーバーでマルチユーザー/マルチテナントの VRAM 分割を実現。チャネル掲載価格は約 16,700〜26,900 ドル/枚(Newegg などチャネル情報[3]);Supermicro など OEM から 8 枚搭載 PCIe サーバー完成品形態もあり(Xeon 6900/EPYC 9005 搭載、公開報道情報[2])。本機は「96GB 大容量 VRAM のラック搭載」に対する公式の回答であり、1 枚あたりのポジションは L40S(48GB)と HGX ベースボード(8 枚 HBM)の中間の密度スイートスポット。
購入前に確認すべき 3 点:① NVLink 非搭載——複数カード間は PCIe のみで、大規模モデル学習の拡張性は本領ではない(ワークステーション版と同様);② 96GB は GDDR7 帯域クラス(約 1.6TB/s)で、スループット重視のワークロードでは HBM 搭載カードにまだ世代差あり;③ パッシブ冷却=シャーシ風路が必須前提(A16 と同じ理屈)。
適用シーンFIT
AIXX Index(0–100):本データベースは公開スペックから重み付けして算出——メモリ 40% + インターコネクト 30% + エコシステム 30%、ユースケース別に重みを調整。手法は透明で検証可能ですが、性能の保証を構成するものではありません。
沿革HISTORY
2025 年 3 月、GTC で RTX PRO Blackwell ファミリー発表(ワークステーション/モバイル/サーバーの 3 ライン、公開報道情報[2])。
2025–2026 年、サーバー版がチャネルで流通開始:Newegg など小売チャネルで約 16,700〜26,900 ドル/枚(チャネル情報[3]);Supermicro など OEM の 8 枚搭載完成品も登場(公開報道情報[2])。
2026 年、「96GB のラック搭載」が推論/VDI 密度構築の定番選択肢に(相場は下表参照)。
技術仕様SPECIFICATIONS
| 項目 | 仕様(公式/チャネル情報、2026-10 検証[1]) |
|---|---|
| アーキテクチャ | NVIDIA Blackwell(RTX PRO ファミリー) |
| CUDA | 24,064 コア(チャネル掲載情報[1]) |
| メモリ | 96GB GDDR7 with ECC · 512-bit · 約 1,597GB/s(チャネル掲載情報[1]) |
| RT Core | 355 TFLOPS(チャネル掲載情報[1]) |
| MIG | 最大 4 分割 · 1 スライス 24GB(チャネル掲載情報[1]) |
| 消費電力 | 最大 600W 設定可 · パッシブ冷却(サーバー風路) |
| インターフェース | PCIe Gen5 x16 |
| 映像出力 | 4× DisplayPort 2.1(チャネル掲載情報[1]) |
| システム形態 | Supermicro など 8 枚搭載 PCIe サーバー(Xeon 6900/EPYC 9005 搭載、公開報道情報[2]) |
仕様は NVIDIA 公式およびチャネル掲載ページによる(2026-10 検証[1]);AI TOPS は NVIDIA 公式 RTX PRO ページ基準;小売チャネル価格はチャネル情報であり公式価格ではない。
選定比較 · 96GB ラック搭載の 3 ルートCONTEXT
| 項目 | RTX PRO 6000 Server | L40S | HGX B300(8 枚ベースボード) |
|---|---|---|---|
| 単体メモリ | 96GB GDDR7 ECC | 48GB GDDR6 | 288GB HBM3E クラス |
| 帯域幅 | 約 1.6TB/s(チャネル情報[1]) | 864GB/s | HBM クラス |
| インターコネクト | PCIe(NVLink なし) | PCIe | NVLink5 14.4TB/s |
| 消費電力/枚 | 最大 600W 設定可 | 350W | kW 級/枚 |
| 選定を一言で | 大容量 VRAM ラック密度 | コスパ重視の推論 | フラッグシップ学習/推論 |
比較は公開情報による;96GB 大容量 VRAM カードと HBM カードの帯域世代差は学習スループットに大きく影響——推論/VDI/レンダリング用途は密度と予算で判断。
ファミリー構成FAMILY
RTX PRO 6000 Blackwell ファミリー(同チップ 3 形態):
冷却と導入COOLING
サーバー版はパッシブ冷却+消費電力設定可(チャネル情報[1]):上限 600W はシャーシ風路とサーバー冷却仕様が必須前提——Supermicro など OEM の 8 枚搭載完成品はこれを前提に風路設計済み;自作環境では必ず「600W×枚数」で冷却を見積もり、消費電力設定を下げて密度を取ることも可能。MIG×4 分割(チャネル情報[1])により 1 枚のカードで 4 つの軽負荷テナント/ユーザーに対応——ラック密度と利用率が本機の売り。
モデル対応MODEL FIT
| 用途 | 96GB VRAM の搭載目安(推算:重み×精度+KV/フレームワーク オーバーヘッド) |
|---|---|
| 70B クラス FP8 常駐 | 重み約 70GB クラス:1 枚で収まる(推算情報) |
| 数百 B クラス 4-bit 推論 | 重み約 50〜60GB:1 枚で余裕あり(推算情報) |
| MIG ×4 分割 | 1 スライス 24GB:13B クラス FP16 の仮想インスタンス 4 つ(推算情報) |
| ファインチューニング | LoRA/QLoRA の中小モデルは 1 枚で実行可(推算情報) |
| 非該当 | 複数カードでの大規模学習(NVLink なし、チャネル情報[1]) |
ギャラリーGALLERY
動画解説VIDEO
本項目の動画解説は制作順番待ち(中国語/多言語版の制作フローは動画枠の制作スケジュール参照)――公開後このブロックは自動更新される。
ソフトウェアとエコシステムECOSYSTEM
CUDA フルスタックのコンシューマー workstation 級フル仕様:vGPU ライセンスで仮想化分割可(A16 のGPU強化版に対抗);PyTorch/TensorRT/ollama ネイティブ対応;AI Enterprise 互換(エコシステム情報)。ワークステーション版と同チップ——ドライバーはライン分け(Studio/GameReady vs データセンター ドライバー)を用途で選択。
調達と検品PROCUREMENT
ストレステストの方法BENCH TEST
検証ツール:nvidia-smi/DCGM(MIG 分割の有効化/消費電力設定)、3DMark(RT Core 基準 355 TFLOPS の確認)、gpu-burn(600W 設定での焼き込みテスト)、LLM ベンチマーク(96GB 搭載実測)。パッシブカードの検収核心=「風路要件を満たした状態で 600W 連続動作時のクロック低下なし」。専用判定記事は鋭意制作中。
輸送と納品LOGISTICS
| 項目 | 要点 |
|---|---|
| フォームファクター | フルサイズ 2 スロット パッシブの大型カード——静電気対策+フィンの圧迫防止(ファンなしのためヒートシンク変形に注意) |
| 国境越え | コンシューマー ワークステーション区分——最新の輸出規制リストと税関基準に従う |
| 保険 | 貨物価値に応じた保険加入(万米ドル級);開梱動画を証拠として保存 |
バリエーションVARIANTS
| バリエーション | 位置づけ |
|---|---|
| Server Edition(本項目) | パッシブ冷却 · ラック密度 · 600W 設定可 |
| ワークステーション版 | 空冷ファン · 4× DP2.1 · クリエイティブフラッグシップ(当サイト項目) |
| OEM 8 枚搭載完成品 | Supermicro など PCIe サーバー(公開報道情報[2]) |
限界と論点LIMITS
- NVLink 非搭載:複数カードの接続は PCIe——大規模モデル学習の拡張性は制約あり(ワークステーション版と同様、チャネル情報[1])。
- 600W パッシブ冷却:シャーシ風路が必須前提——自作環境ではクロック低下のリスクが高く、OEM 完成品を優先。
- チャネル価格差が大きい:小売チャネル情報で 16,700〜26,900 ドル/枚([3])——価格差と保証を見比べること。
- GDDR7 帯域クラス:約 1.6TB/s(チャネル情報[1])——HBM カードとのスループット世代差は残る。推論/VDI 用途は密度で選択。
- MIG 上限 4 分割:マルチテナントの細かさはデータセンター カードのマルチインスタンス粒度に及ばない(業務で比較)。
相場情報MARKET
| 日付 | タイプ | マーケット | 価格帯 | 基準 |
|---|---|---|---|---|
| 2026-10 | 小売チャネル | 海外 | 約 16,700〜26,900 ドル/枚(チャネル情報[3]) | 小売チャネル |
| 2026-10 | システム形態 | 海外 OEM | 8 枚搭載完成品は OEM 価格による | 出品検索 › |
基準:小売チャネル価格はチャネル情報であり公式価格ではない。相場と在庫:AIXX 取引所(手数料ゼロのマッチング、取引には関与しない)。
年表MILESTONES
| 期間 | 出来事 |
|---|---|
| 2025-03 | GTC で RTX PRO Blackwell ファミリー発表(サーバー版は 3 ラインの一角)[2] |
| 2025–2026 | チャネル流通開始:小売で約 16,700〜26,900 ドル/枚;OEM 8 枚搭載完成品も登場(情報[1][2]) |
よくある質問FAQ
関連項目SEE ALSO
参考文献REFERENCES
| [1] | NVIDIA 公式 · RTX PRO Blackwell ファミリー情報(96GB GDDR7 ECC/4000 AI TOPS クラス/MIG) · https://www.nvidia.com/en-us/products/workstations/rtx/(2026-10 検証) |
| [2] | 販売ページ · Newegg などの小売チャネルの仕様と価格(96GB GDDR7 ECC/24064 CUDA/512-bit/1597GB·s/600W/DP2.1×4) · https://www.newegg.com/p/pl?d=rtx+pro+6000+blackwell+96gb(チャネル表記 2026-10) |
| [3] | 公開報道 · RTX PRO Blackwell ファミリー発表と OEM 8枚構成マシン(Supermicro など) · https://www.reuters.com/technology/(報道ベース) |
| [4] | 当サイト · RTX PRO 6000 ワークステーション版の項目(同チップ比較) · /wiki/rtx-pro-6000.html(当サイト項目) |
仕様はNVIDIA公式の情報を基準とし、小売チャネル価格はあくまでチャネル側の数値であり当ライブラリは保証しません。調達は公式の確定文書と実測に基づいてご判断ください。