AIXX 百科 › ハードウェア用語 › Grace CPU
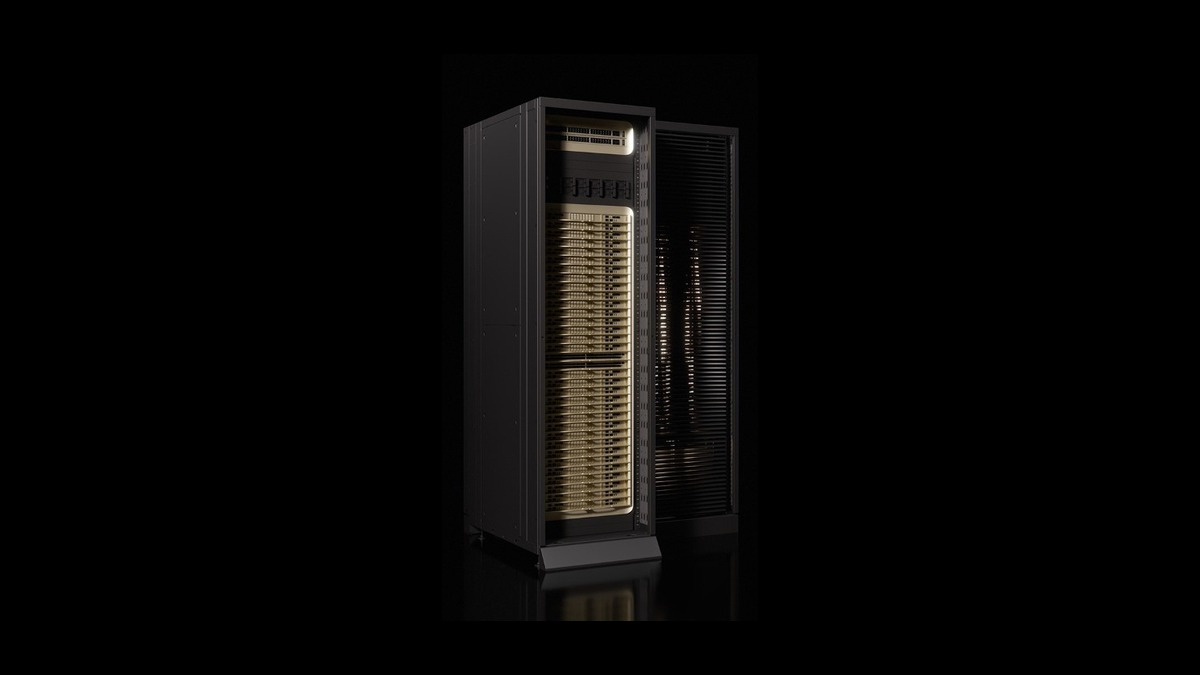
Grace CPU
概要OVERVIEW
GraceNVIDIA のデータセンター CPU ブランド——NVIDIA 初の自社開発 CPU:Arm Neoverse V2 コア採用の 72 コアプロセッサで、AI と HPC の大容量メモリ帯域のために設計(NVIDIA 公式ページの情報[1])。単体で登場することはほとんどなく、主役の座にあるのは Grace Hopper(GH200)と Grace Blackwell(GB200/GB300)スーパーチップ内の CPU 側——GPU と NVLink-C2C チップ間インターコネクトで結ばれ、「CPU+GPU 一体型」のスーパーチップを構成する。
その存在意義はCPU と GPU の関係を作り直すこと:従来アーキテクチャでは CPU と GPU の間に PCIe が介在し、データのやり取りはコピーの繰り返しでした。Grace と GPU の間は NVLink-C2C のコヒーレント・インターコネクト(GB200 スペックで 900GB/s 級[2])——ソフトウェアから見れば CPU メモリと GPU メモリが一続きになり、ベクトルデータベース、データ処理、KV cache 管理といった「CPU 側の処理」が GPU 級の帯域を直接活用できます。
2026 年の現物市場では、Grace は GB200/GB300 ラックの構成要素として流通しており(36 個/ラック)、単体形態(Grace CPU Superchip の単体販売)は珍しい。本項では相場を掲載しない——実際の価格は出品者の提示価格によります。
適用シーンFIT
AIXX Index(0–100):CPU-GPU 連携シナリオとの適合度で重み付け(ソフトウェア概念に特化した指標)。
沿革HISTORY
2021 年 4 月、GTC で Grace を発表:NVIDIA が CPU 市場への参入を宣言——Arm Neoverse コアを採用した AI・HPC 向けデータセンター CPU で、名前はコンピュータアーキテクチャの先駆者 Grace Hopper に由来(NVIDIA 公式ページと GTC 発表の情報[1])。
2022-2023 年、スーパーチップが製品化:Grace Hopper(GH200、Grace+H100 を NVLink-C2C で接続)がまず出荷され、Linux カーネルと主要ディストリビューションで Arm エコシステムへの対応が完了——「CPU+GPU のコヒーレントメモリ」が論文から製品へ(公式ページの情報[1])。
2024〜2025 年、GB 世代の量産拡大:Grace Blackwell(GB200)と GB300 が Grace をラック級の主力に押し上げ——GB200 NVL72 は 1 ラックに 36 個の Grace が 72 個の B200 へのデータ供給を担い、LPDDR5X の大容量メモリプールがラックの「第二の VRAM 層」となる(GB200 項目の見解)。
2026 年、現物市場での位置づけ:Grace は GB 系ラックに随伴して流通し、単体形態は稀。Arm データセンター CPU 陣営(Grace/AWS Graviton/Ampere など)は全体として成長中だが、AI スーパーチップの領域で Grace は現在「GPU 大手の自社開発 CPU」として唯一の存在。データセンター向けチップの越境流通政策は依然流動的であり、調達時は主管当局の政策と専門家の意見を優先(公開報道の見解)。
技術仕様SPECIFICATIONS
| 項目 | スペック(NVIDIA Grace CPU Superchip · 公式見解) |
|---|---|
| コア | 72 コア Arm Neoverse V2(1 スーパーチップあたり) |
| メモリ | LPDDR5X ECC——省電力志向の大帯域メモリ(容量は構成による) |
| インターコネクト | NVLink-C2C——CPU↔GPU コヒーレント・インターコネクト(GB200 スペックで 900GB/s 級[2]) |
| スーパーチップ形態 | Grace Hopper(GH200:Grace+H100)· Grace Blackwell(GB200:2×B200+1×Grace) |
| ラック内での役割 | GB200/GB300 NVL72:1 ラックに 36 個の Grace(72 コア ×36=2592 コア/ラック) |
| ソフトウェアエコシステム | Linux(主要ディストリビューションの Arm 版)· NVIDIA フルスタックのネイティブサポート |
| 発表 | 2021-04 GTC で発表 · GH200 2023 年出荷 · GB200 2024-03 発表 |
スペックは NVIDIA 公式ページを基準(2026-10 時点)[1]。クロック/消費電力/メモリ容量などの細目は対応するスーパーチップおよびシステム構成に依存します。本表に記載のない項目=未検証であり、推測で補完しません。
GB 系ラックにおける Grace の位置IN THE RACK
| 階層 | 構成要素 | Grace との関係 |
|---|---|---|
| チップレベル | Grace Blackwell スーパーチップ(2 B200 + 1 Grace) | NVLink-C2C コヒーレンス・インターコネクト——ソフトウェア視点で CPU メモリと GPU メモリが一体 |
| トレイレベル | コンピュートトレイ(4 GPU + 2 Grace/トレイ) | Grace がトレイレベルのデータ処理とオーケストレーションを担う |
| ラック級 | GB200/GB300 NVL72 | 36 個の Grace/ラック · 最大 17TB LPDDR5X メモリプール(ラックスペック) |
階層の定義は GB200 NVL72 項目と一致;GB300 の Grace 構成は整机メーカーのドキュメントに準じる。
ファミリー構成FAMILY
Grace ファミリはスーパーチップの組み合わせで分類;Grace は GB 系の CPU 側の本体:
冷却と導入COOLING
Grace は独立したサーバー形態では展開されない——スーパーチップとコンピュートトレイに実装され、冷却はシステム全体のソリューションに従う(GB 系はフル液冷)。展開の観点での Grace の課題はソフトウェアスタックの問題:Arm アーキテクチャであるため、すべてのホスト側ソフトウェア(監視エージェント、セキュリティコンポーネント、自社ツールチェーン)で Arm 版の可用性を確認する必要がある——主要 Linux ディストリビューションと NVIDIA フルスタックはネイティブ対応済みだが、企業内のロングテールなソフトウェアは個別に棚卸しが必要(本庫の整理見解)。
中古ラック検収時の Grace 側チェック項目:36 個の CPU すべての搭載認識、NVLink-C2C リンクの健全性(NVLink ドメイン検収と同じ批次で実施)、LPDDR5X メモリ容量と構成が添付書類と一致——Grace 障害のトレイレベル修理は整机メーカーのチャネルに依存するため、調達時に保証経路を確認すること。
用途適性WORKLOAD FIT
| ワークロード | Grace の性能の見方 | AIXX Index |
|---|---|---|
| 学習データパイプライン | 前処理/拡張/トークン化が CPU 側で NVLink-C2C の帯域を直接使い GPU へ供給 | 86 |
| ベクトルデータベース / 検索 | 大容量メモリプール+コヒーレンス・インターコネクト、ベクトル検索のホットデータ層に適合 | 83 |
| 推論 KV cache の階層化 | LPDDR5X の大容量プールを GPU メモリのオーバーフロー層として活用(GB200 項目の見解) | 83 |
| 汎用 x86 アプリの移行 | Arm エコシステムで動くものの本来の位置づけではない——上表「汎用代替」の見解に従う | 45 |
ワークロード分類は当データベースによる公開スペックからの整理(推定基準、性能保証ではありません)。
ギャラリーGALLERY
実写画像は検品ロットに合わせて順次追加;AI 生成画像は実写と偽らない。
ソフトウェアとエコシステムECOSYSTEM
| 項目 | 要件 / 現状 |
|---|---|
| OS | 主要 Linux ディストリビューションの Arm 版(Ubuntu/RHEL 系など、公式サポートの見解) |
| NVIDIA フルスタック | CUDA/ドライバ/NCCL などが Grace をネイティブサポート——GB 系ラックのソフトウェアスタックとして一体的に提供 |
| フレームワーク | PyTorch/TensorFlow などの AI フレームワークの Arm ホイールが利用可能、データ側コンポーネント(DALI など)は NVIDIA スタックに随伴 |
| コンテナ化 | Arm コンテナイメージのエコシステムは成熟(マルチアーキテクチャイメージは業界の標準) |
| 棚卸しの注意 | 企業自社ツール/セキュリティエージェントの Arm 版可用性を個別に確認——移行の主な摩擦点(本庫の整理見解) |
Arm データセンターエコシステムは AWS Graviton などの製品による長年の育成を経て成熟;バージョンは時間とともに進化し、NVIDIA の公式発表に準じる。
調達と検収PROCUREMENT
Grace 関連の調達(GB 系ラック随伴)の検収要点(3 項目):
検収クイックリファレンスQUICK CHECK
Grace 側の 4 ステップ迅速チェック(GB 系ラック検収時に実施):
輸送と納品LOGISTICS
用語カードGLOSSARY
NVLink-C2C
チップ間インターコネクト:Grace と GPU の間のコヒーレンス高速インターコネクト(GB200 スペックで 900GB/s 級)——CPU メモリと GPU メモリをソフトウェア視点で一体につなげる、Grace を「外付け CPU」と区別する本質。
LPDDR5X
低消費電力版 LPDDR5 メモリ:Grace のメモリ選択——省電力志向・大帯域で、「CPU 側の大容量メモリプールで GPU に供給する」という位置づけに奉仕(GB200 ラックスペックで 17TB 級メモリプール)。
スーパーチップ(Superchip)
Grace+GPU のパッケージ組み合わせ:Grace Hopper(GH200)、Grace Blackwell(GB200 系)——「CPU+GPU のマザーボード上の関係」を「チップパッケージの関係」に圧縮し、インターコネクト帯域とコヒーレンス制約を完全に再構築。
Neoverse V2
Arm のデータセンターコア IP:Grace 採用の 72 コア Neoverse V2——AWS Graviton3/Ampere One と同じ系譜のデータセンター Arm 血統で、エコシステムのツールチェーンを共有。
Vera CPU
NVIDIA 公開ロードマップ上の次世代 CPU(Vera Rubin プラットフォームとともに発表)——Grace の後継;ロードマップの内容は NVIDIA の公式発表に準じる。
限界と論点LIMITS
- 単体形態の稀少さ:Grace はほぼ GB 系スーパーチップに随伴してのみ流通——「Grace サーバー」を単体で調達したい案件は、整机メーカーに対応ソリューションがあるか確認が必要(本庫の整理見解)。
- Arm ソフトウェアスタックの棚卸しコスト:企業のロングテールなソフトウェアの Arm 版可用性を個別に確認する必要——主要ディストリビューションと NVIDIA スタックはネイティブ対応済みで、摩擦点は自社製・レガシーソフトウェアにある(本庫の整理見解)。
- x86 エコシステム互換の境界:一部の x86 専用バイナリ/ドライバ(一部の HBA カードのファームウェアツールなど)は Arm では利用不可——GB 系ラックの拡張カード選定では Arm 対応を確認すること。
- 修理チャネルは整机メーカー依存:Grace はトレイに実装されており、障害修理は整机メーカーのトレイレベル交換となる——中古ラック調達時は保証経路とスペアパーツのチャネルを契約に明記すること(本庫の検品経験の見解)。
- 越境流通の政策変数:GB 系スーパーチップは輸出管理の対象となりやすい機種です(報道ベースの情報)——本データベースは政策動向の留意用であり、法的助言を構成するものではありません。
相場情報MARKET NOTE
Grace は GB 系ラックの構成要素として流通しており、独立した相場は存在しません——本ライブラリの誠実さの原則:相場帯を設けず、価格は出品者の実際の提示価格によります(ラックレベルの価格は GB200/GB300 NVL72 の各項目の基準による)。
販売検索:AIXX 取引所ロビー ›(手数料ゼロのマッチング、取引には関与しないため、データは中立的)。
価格イベント年表MILESTONES
よくある質問FAQ
位置的には違います:Grace は「CPU+GPU スーパーチップ」のために設計されており、その価値は NVLink-C2C コヒーレントインターコネクトと大容量メモリプールにある——単体で汎用サーバーとして使うのは、購入面でも運用面でも適切ではありません。汎用コンピューティングは依然として x86 と汎用 Arm サーバー(Graviton など)の領域です。
アーキテクチャもユースケースも異なるため、単純な換算はできません——Grace の強みはメモリ帯域と CPU-GPU 連携(NVLink-C2C)であり、汎用整数/浮動小数点スループットの横並び比較はあまり意味を持ちません。選定では、ワークロードが「GPU にデータを供給するパイプライン」かどうかが鍵で、そうであれば Grace+GPU の組み合わせに大きな優位性があり、そうでなければ無理に適用すべきではありません。
トレイレベルの保守:Grace はコンピュートトレイにはんだ付けされており、故障時は整机メーカーのトレイ交換ルートを通ります——中古ラック購入時は保証経路とスペアトレイを契約書に明記すべきで、これがラック級機器の隠れたコストです。
成熟しています:PyTorch/TensorFlow には Arm 版 wheel があり、NVIDIA のフルスタックは Grace をネイティブサポート、マルチアーキテクチャのコンテナイメージも業界の標準となっています——摩擦点は企業内の自社開発ツールやレガシーソフトの Arm 対応状況の棚卸しで、購買前にリスト化を。
間接的には競合です:GB 系ラックでは Grace が従来の「x86 サーバー+GPU」の CPU ポジションを置き換えています——ただし競争は「AI クラスタの CPU 側」という細分化された領域で発生しており、汎用データセンター CPU 市場では依然 x86 と汎用 Arm が主流です。
関連項目SEE ALSO
関連記事EXPLORE
参考文献REFERENCES
- NVIDIA 公式 — Grace CPU 製品ページ(スペックの一次情報、2026-10 時点) https://www.nvidia.com/en-us/data-center/grace-cpu/
- NVIDIA 公式 — GB200 NVL72 製品ページ(Grace のラックでの役割と 900GB/s の C2C 基準) https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- Supermicro — SuperCluster GB200 NVL72 Datasheet(トレイ構成の基準) https://www.supermicro.com/datasheet/datasheet_SuperCluster_…
- 出品検索 — AIXX Exchange(AIXX 交易所;手数料ゼロのマッチング;Grace は GB 系ラックとともに流通し、独立した相場なし) https://www.aixx.vip/hall.html?model=GB200