SECTIONS
EDITIONS
NETWORK
萬安百科 › 机柜词条 › 华为 CloudMatrix 384 超节点
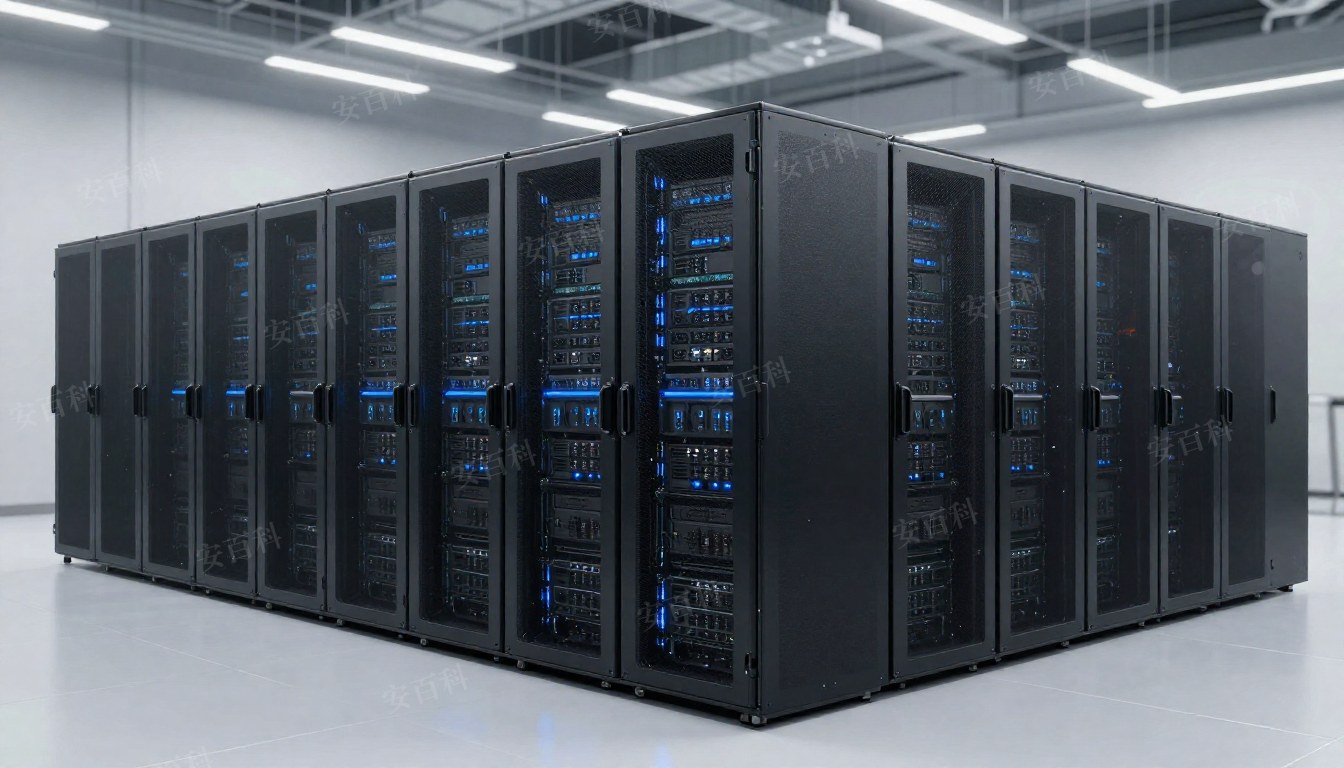
示意配图(AI 生成·非官方产品图)· 萬安百科
华为 CloudMatrix 384 超节点
384×910C · 300 PFLOPS BF16 · 灵衢全对等互联 · 国产超节点词条
概述OVERVIEW
CloudMatrix 384(CM384) 是华为的超节点(超级节点)系统:2025 年 9 月 18 日华为全联接 大会公开(徐直军主题演讲口径)——集成 384 颗昇腾 910C 与 192 颗鲲鹏 920,经自研 灵衢(UnifiedBus)高速互联协议全对等互联,"384 颗芯片像一台计算机一样工作",最大算力 300 PFLOPS(BF16)(大会口径)。物理组成为 12 个计算柜 + 4 个总线柜(多方公开报道口径), 采用光互联技术——对位英伟达 GB200 NVL72 的"以规模换性能"路线。
沿革HISTORY
- 前史:Atlas 900 集群时代——华为大规模训练集群的积累期(官方口径)。
- 2025-09-18:HC 大会公开 CM384 超节点(384×910C·300 PFLOPS BF16·灵衢)——公开对标 NVL72。
- 2026:灵衢 2.0 起计划开放技术规范、构建开放超节点生态(大会口径);芯片代际向 950 系演进(路线图口径,950PR 词条)。
对标与谱系GENERATIONS
| 维度 | CloudMatrix 384(本词条·大会口径) | NVIDIA GB200 NVL72(对照) | 昇腾单机 8 卡(800T A2 系) |
|---|---|---|---|
| NPU/GPU 规模 | 384× 昇腾910C + 192× 鲲鹏920 | 72× GB200 Blackwell | 8× 910B |
| BF16 算力 | 最大 300 PFLOPS(大会) | 约 180 PFLOPS(公开口径) | 约 2.24 PFLOPS(标称) |
| 互联 | 灵衢全对等 + 光互联(大会) | NVLink 5 / NVSwitch | HCCS + 200GE RoCE |
| 形态 | 12 计算柜 + 4 总线柜(报道口径) | 单机柜 NVL 形态 | 4U 服务器 |
| 取舍 | 堆叠规模换性能·功耗更高(SemiAnalysis 分析口径) | 单柜密度路线 | 存量普及路线 |
口径:CM384 列=华为 HC 2025 大会公开口径;NVL72 列=公开报道口径;功耗取舍=SemiAnalysis 独立分析口径。跨体系精度与互联定义不同,数字为规模级对照非同口径直比。
系统构成SPECS
| 项目 | 口径 |
|---|---|
| NPU | 384× 昇腾 910C(大会口径) |
| CPU | 192× 鲲鹏 920(公开报道口径) |
| 最大算力 | 300 PFLOPS BF16(大会口径) |
| 互联 | 灵衢(UnifiedBus)全对等互联 · 光互联——通信带宽较传统组网提升约 15 倍、时延降低约 10 倍(公开报道口径) |
| 物理形态 | 12 个计算柜 + 4 个总线柜(报道口径) |
| 逻辑形态 | "384 颗芯片像一台计算机一样工作"(大会口径) |
| 软件栈 | CANN · MindSpore / PyTorch 适配(昇腾生态口径) |
| 生态开放 | 灵衢 2.0 起计划开放技术规范(大会口径) |
集群与部署角色DEPLOYMENT
| 场景 | 角色口径 |
|---|---|
| 千亿级训练 | 300 PFLOPS BF16 级单超节点(大会口径)——大模型预训练的重型单元 |
| 推理集群 | 超节点大显存池+全对等互联——高并发大模型服务底座(体系能力口径) |
| 选型前提 | 机房供电/承重/光互联布线按整柜体系规划——功耗账连对标一起算(SemiAnalysis 口径提醒) |
超大集群档——去模型广场按需调用
萬安云 · 模型广场 →局限与边界LIMITS
- 功耗账:第三方分析口径功耗显著高于 NVL72——机柜电力与冷却规划是第一约束(SemiAnalysis 口径)。
- 芯片代际:本体系基于 910C——950 系新代超节点按路线图接续(大会口径),采购对批次。
- 规格公开度:整机柜级完整规格表未见官方逐项公开——本词条以大会口径+报道口径拼合,采购以华为交付方案为准。
常见问题FAQ
CloudMatrix 384 到底是什么形态?
超节点(超级节点):12 个计算柜 + 4 个总线柜组成一台「逻辑计算机」——384 颗昇腾 910C + 192 颗鲲鹏 920 通过灵衢(UnifiedBus)全对等互联协同(大会与多方公开报道口径),不再是单机柜 8 卡的堆叠。
算力对标 NVL72 是什么水平?
大会口径最大 300 PFLOPS BF16——公开对比约为英伟达 GB200 NVL72 系统(约 180 PFLOPS BF16)的 1.7 倍;第三方分析(SemiAnalysis)指出其代价是功耗更高、以堆叠规模换性能——对标要连功耗一起算账。
为什么用 910C 而不是最新 950 系?
超节点与芯片代际是两条线:CM384 以 910C 的量产规模+灵衢互联成体系(大会口径);950 系新代芯片与 Atlas 650E/新超节点按路线图接续——买超节点看交付批次与互联代际,不只看芯片代。
相关词条SEE ALSO
NVIDIA GB200 NVL72(对标)
华为昇腾 950PR(新代芯片)
Atlas 800T A2(单机 8 卡对照)
Atlas 650E(950DT 新代整机)
CANN(昇腾软件栈)
HGX B300 NVL16(对照)