2026-11-03 · 出典:虎嗅·中继
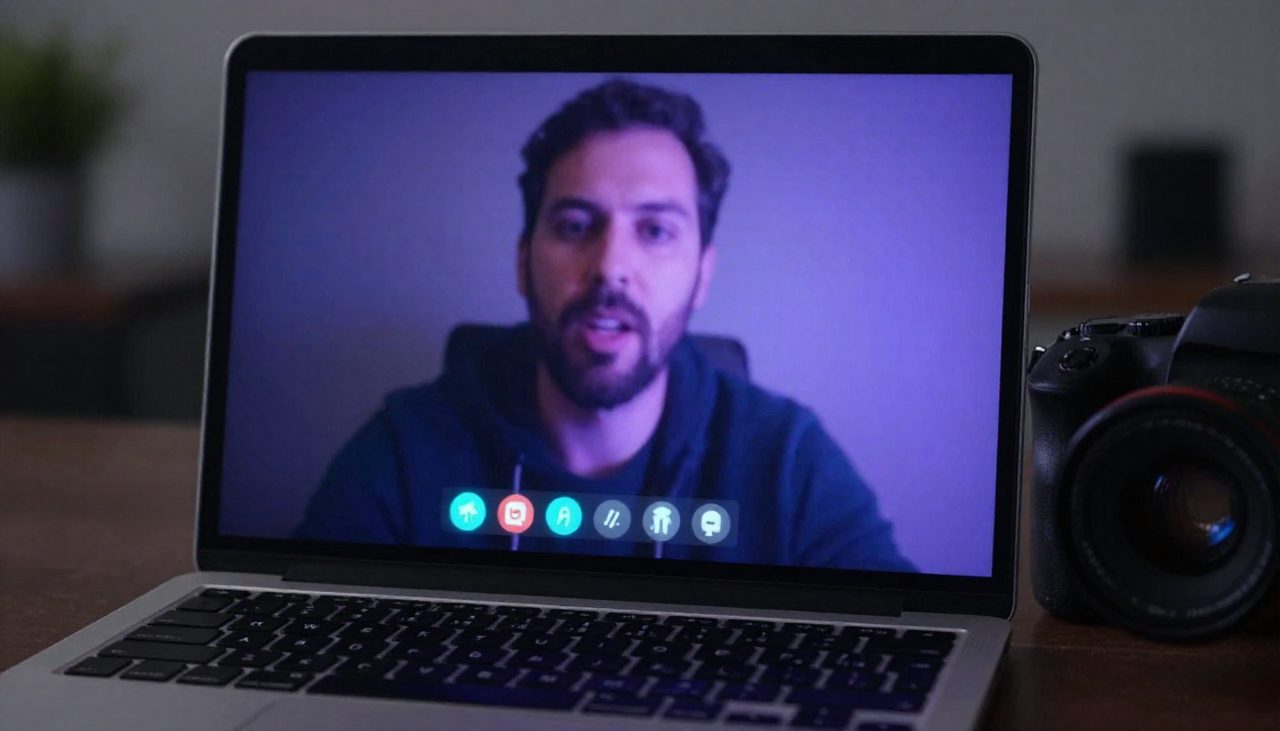
「見た目は真実」という本人確認の常識が揺らぐ。ただしテスト基準はTavus独自のもので、プレビューはまだ全面公開されていない
この数字を見てから「百聞は一見に如かず」を語ろう。Tavusのリサーチプレビュー版モデルGriffin-Liteと1分間通話したところ、参加者54名のうち26名が画面の相手を本物の人間と誤認、割合は約48%。一方、前世代システムでは同じ手順で41名中わずか1名、誤認率は2.4%だった。
Tavusはこれを根拠に、Griffinをリアルタイムの「ビデオ・チューリングテスト」を初めて突破したモデルと定義し、新カテゴリHuman Interaction Model(人間インタラクションモデル、HIM)として位置づけた。執筆時点で、この実験は約1736万人のネットユーザーがオンラインで見守った。ただし「初めて突破」は現時点でTavus自身の結果に対する定義であり、モデルのプレビューもまだ全面公開されていないため、誇大なデモの可能性は排除できない。
今回の発表で真に注目すべき技術的ポイントは、インタラクションパラダイムの切り替え、すなわちカスケードから全二重への移行だ。一般的なカスケードシステムは、音声認識、言語モデルによる応答、音声合成、デジタルヒューマン駆動をパイプラインでつなぎ、ユーザーが話し終えてから初めて処理を行う。これに対しGriffinは、音声と映像を出力しながらユーザーの音声・映像を継続的に受け取る。その持続対話モデリングエンジンは1秒未満の間隔で対話状態を再評価し、相手の表情、視線、口調、沈黙を踏まえて何を話すか、いつ割り込むかを決め、感情・表情・動作の制御信号を出力して、音声映像生成エンジンが連続した声と映像へ変換する。同じ沈黙でも、相手が考えているのか、話し終えたのか、それとも説明の続きを促しているのかを判別する必要がある――こうした言語以外のディテールこそ、AIが会話で最も露呈しやすい部分だ。
ビジュアル生成の範囲も拡大している。Tavusによれば、Griffinは1枚の参照画像から顔、腕、指といった人物の部分に加え、椅子の移動、影、背景の変化まで画面全体をリアルタイムに生成できるため、キャラクターは発話を待たずに、聞きながら頷いたり視線を調整したり表情を変えたりできる。公式デモには、ものまね指示ゲーム、ルービックキューブとのインタラクション、ユーザーが基板をはんだ付けする様子の観察などのシーンも含まれていた。カメラ映像までもがリアルタイム生成できる以上、ビデオを開くことを本人確認の最後の保険とみなす前提は、見直しが必要だろう。
タグ: Tavus · Griffin · Video Turing Test · Full-Duplex · Human Interaction Model · Digital Human
萬安算交所 AIXX · AIXX · 検証済みコンピュート取引所 · 現貨ホールへ